Agents IA : la fiabilité et la facture ne viennent pas du modèle, elles viennent de vos API
Le 16 septembre 2026, j’ai présenté au FDDAY avec Simon Guerrier, Product Manager chez Postman, une session sur les agents IA. On a choisi de parler de ce qui arrive après le premier prototype réussi, quand l’agent qui marchait en démo devient instable et cher dès qu’on le branche sur les vrais systèmes. C’est en général le moment où les équipes arrêtent de débattre du modèle et découvrent qu’elles ont un problème de plomberie.
Ce qu’on a défendu pendant quarante minutes tient en une phrase : la fiabilité d’un agent et le montant de sa facture ne dépendent pas du modèle, mais de la qualité de vos API et de votre capacité à gouverner ce qui les appelle.
Le levier principal est donc chez vous, dans des systèmes que vous possédez déjà.
De quoi un agent est fait
Un agent, c’est trois briques appelées en boucle.
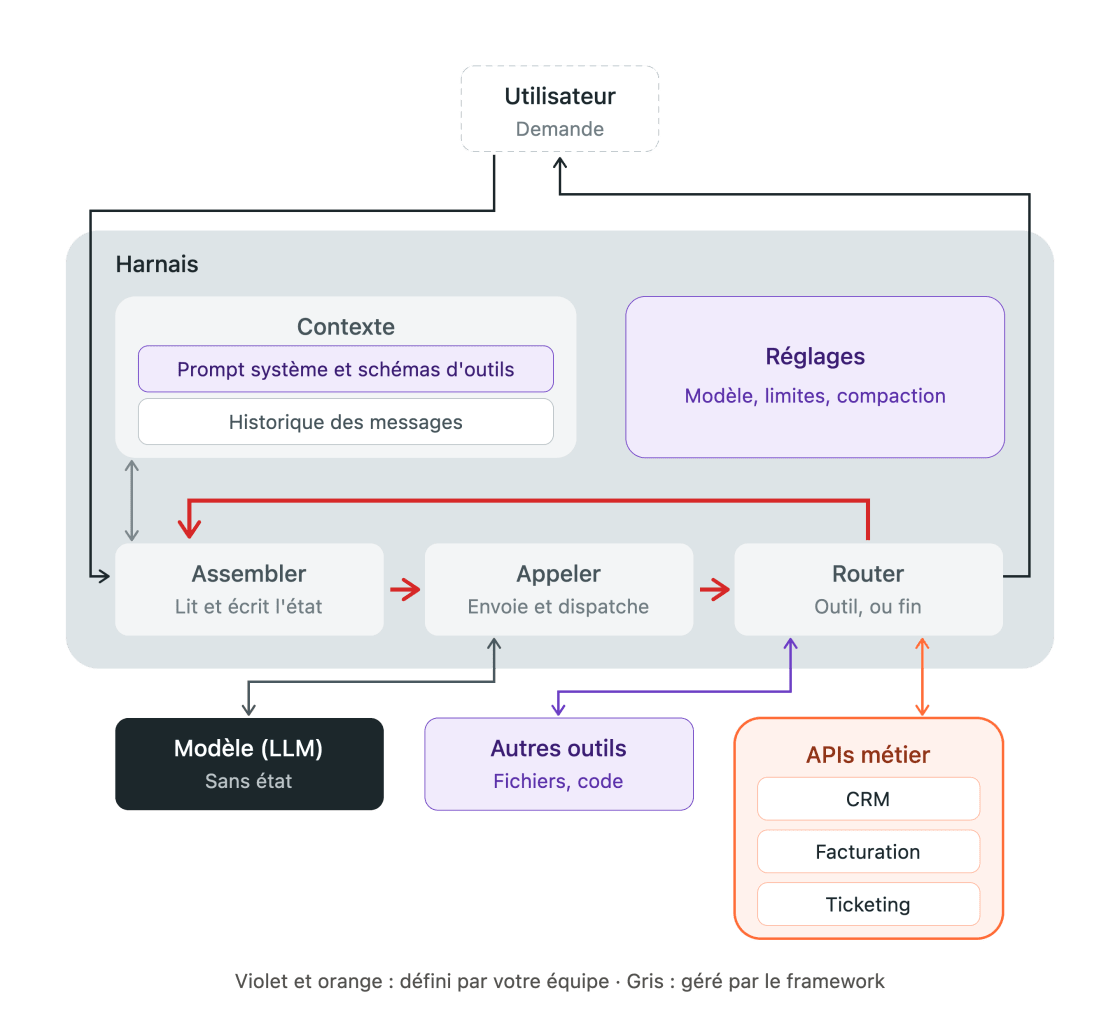
- Le modèle, en bas à gauche. Il est sans état : il ne retient rien d’un appel à l’autre. C’est important, parce que ce n’est pas un cerveau qui apprend de vos échanges, c’est une fonction qu’on rappelle à chaque tour avec tout le contexte.
- Le harnais, la grande zone grise. C’est votre code, ou celui de votre framework. C’est lui qui tient le contexte, composé du prompt système, qui définit comment l’agent doit se comporter, des schémas des outils qu’il va utiliser, et de l’historique des messages. C’est lui aussi qui fait tourner la boucle : il assemble le contexte, il appelle le modèle, il route vers un outil ou il s’arrête.
- Les outils, en bas. Des fichiers, du code, et surtout, en orange, vos API métier. Votre CRM, votre facturation, votre ticketing.
Le déroulé d’un tour se lit sur le schéma. Le message part vers le harnais, qui récupère son contexte pour savoir comment traiter la requête et sur quel ton répondre. Ces informations sont envoyées au modèle, qui choisit les outils nécessaires pour traiter la requête et formuler sa réponse. Le harnais exécute l’appel vers l’outil demandé, et on revient à l’étape d’assemblage pour mettre en forme la réponse de l’API. Si le modèle juge les informations reçues pertinentes, on sort de la boucle et la réponse part vers l’utilisateur. Sinon, il tente de corriger le tir et continue d’itérer jusqu’à obtenir une réponse satisfaisante.
Trois choses à retenir de ce schéma :
- Le modèle est loué. Vous le changez en une ligne de configuration. Le harnais, vous l’écrivez. Et les API, vous les avez déjà, pour faire parler vos systèmes entre eux ou pour les exposer à des consommateurs externes.
- La boucle repasse tout le contexte au modèle à chaque tour. C’est le circuit en rouge sur le schéma, assembler, appeler, router, et retour à l’assemblage. À chaque passage, le modèle reçoit à nouveau le prompt système, les schémas d’outils, et l’historique qui grossit. C’est là que partent les tokens, et c’est le fil rouge de tout l’article.
- Le modèle décide, votre code exécute. Aucune garantie ne peut venir du modèle. S’il décide d’appeler votre endpoint de remboursement, il l’appelle.
Le coût grimpe plus vite que le nombre de tours
Le coût d’une tâche s’écrit comme ça :
( prompt système + schémas d'outils + requête )   ← fixe
+ ( historique )                                  ← grossit à chaque tour
× itérations
La partie qui grossit est la partie qui se multiplie. Prenons une base plausible : 4 000 tokens fixes, et un historique qui s’allonge de 1 500 tokens par tour (la décision du modèle, l’appel d’outil, la réponse de l’API).
| Itérations | Tokens facturés en entrée |
|---|---|
| 5 | 35 000 |
| 10 | 107 500 |
| 20 | 365 000 |
Les curseurs ci-dessous appliquent cette formule. Le troisième fait varier le nombre de tours, et les deux scénarios en bas comparent une API propre à une spec floue, sur des réglages identiques.
Mêmes réglages, seul le nombre de tours change. Cliquez pour appliquer.
La spec floue coûte 12 fois plus cher que l'API propre, sur exactement la même tâche.
Voir le détail tour par tour
| Tour | Entrée de ce tour | Cumul |
|---|
Deux fois plus de tours, trois fois plus de tokens. La raison est simple : en doublant le nombre d’itérations, vous payez deux fois plus souvent un contexte qui a lui aussi doublé de taille. C’est ce qui explique la plupart des surprises en fin de mois.
Trois leviers pour réduire les coûts
Sur cette facture, vous avez trois prises. Elles n’ont ni la même amplitude, ni le même propriétaire.
| Levier | Amplitude | Qui le contrôle |
|---|---|---|
| Prix par token | x2 à x5 | Votre fournisseur |
| Tokens par tour | x2 à x3 | Votre harnais |
| Nombre d’itérations | x10 à x100 | Vos API |
Le prix par token se négocie en changeant de modèle, et l’amplitude annoncée vaut à niveau équivalent. Entre deux modèles capables de tenir la même tâche, l’écart de tarif va de deux à cinq fois. Si vous acceptez de descendre à un modèle très standard, celui qui sait résumer un mail, l’écart est bien plus large, mais vous ne parlez plus du même agent. Un modèle qui raisonne mieux réduit par ailleurs le nombre d’itérations tout en renchérissant chaque token : vous échangez un levier contre l’autre, et le gain net est souvent proche de zéro.
Les tokens par tour dépendent de votre harnais, et surtout de deux décisions. Le choix des outils exposés au modèle, parce que chaque schéma d’outil est repassé à chaque tour, qu’il serve ou non. Et les stratégies de gestion du contexte, au premier rang desquelles la compaction, qui résume l’historique dès qu’il dépasse une certaine taille au lieu de le renvoyer intégralement. Attention à ce que ce levier fait vraiment : il réduit le coût d’une itération, pas le nombre d’itérations.
Le nombre d’itérations dépend de vos API. C’est le levier le plus puissant de la liste, de deux ordres de grandeur, et aussi celui dont on parle le moins en réunion. Il vous appartient entièrement.
Une bonne API réduit les itérations sans renchérir quoi que ce soit. Un endpoint qui retourne en un appel ce que l’agent allait chercher en six, un message d’erreur qui dit quoi corriger au lieu de dire « Bad Request », une pagination dont le curseur est explicite : chaque fois, vous retirez des tours de boucle sans payer une seule ligne de plus. C’est le seul levier gratuit de toute l’équation.
Ce sur quoi un agent échoue vraiment
Prenez le même blocage, vu d’abord par un humain puis par un agent.
Un développeur qui bloque sur votre API demande sur Slack, lit le code source, essaie, et retient. Le coût est payé une fois, par une personne, et le savoir reste dans l’équipe.
Un agent qui bloque relit la même documentation, tente à l’aveugle, et ne retient rien. Le coût est payé à chaque exécution, par tous les utilisateurs, indéfiniment.
Le changement est là. Les angles morts de vos API n’ont pas changé de place : ce sont les mêmes qu’avant. Hier, ils créaient un goulot entre l’IT et le métier, un ticket, une réunion. Ce goulot existe toujours, et aujourd’hui ils vous coûtent en plus de l’argent, en tokens, à chaque appel.
L’ambiguïté coûtait du temps, une fois. Maintenant, elle coûte de l’argent, à chaque exécution.
En pratique, le raisonnement métier est rarement en cause. Ce qui bloque, c’est le contrat : comment on s’authentifie, combien d’appels par minute on a le droit de faire et ce qui se passe au-delà, comment on récupère la page suivante d’une liste, ce que veut dire une erreur quand elle tombe, et si on peut rejouer un appel sans conséquence. Un modèle ne peut deviner aucune de ces réponses. Quand elles ne sont écrites nulle part, il invente la sienne, sur un ton parfaitement assuré, et se trompe.
Chaque échec naît dans le cycle de vie de l’API
Les questions qu’un agent se pose se mappent une à une sur les étapes de votre cycle de vie API. C’est le tableau que je garde pour les conversations d’architecture, parce qu’il déplace le débat de « quel modèle choisir » vers « quelle étape est cassée chez nous ».
| L’agent demande | Ce qui casse | Créé à l’étape |
|---|---|---|
| Quelle API ? | Patrimoine éclaté, pas de portail | Publication |
| Quel endpoint ? | Nommage et modélisation flous | Design |
| Comment l’appeler ? | Contrat absent, faux ou implicite | Documentation |
| Et si ça rate ? | Erreurs muettes, rejouabilité inconnue | Test |
| Avec quel credential ? | Rien ne le dit, personne ne l’a décidé | Gouvernance |
Aucun de ces échecs ne vient du modèle. Changer de fournisseur n’en corrige aucun.
Aucun n’est visible à l’endroit où il naît. Une modélisation floue décidée en design se manifeste six mois plus tard sous la forme d’un agent qui tâtonne en production. Personne ne fera le lien tout seul, parce que le symptôme et la cause sont séparés par plusieurs équipes et plusieurs trimestres.
Une seule lacune suffit. Une documentation parfaite ne sauve pas un agent qui ne sait pas quel credential utiliser, et un agent trouve toujours le maillon faible avant vous.
Ce que change une plateforme API unifiée
Un outil de plus dans la chaîne ne règle rien. Le gain vient de la disparition de la chaîne : design, documentation, test, publication et gouvernance cessent d’être cinq ateliers séparés pour devenir cinq étapes d’un même cycle de vie. Deux mécanismes en découlent, et ils comptent plus que n’importe quel chiffre de productivité.
Les quality gates. Un contrôle automatique est posé à chaque étape, et il bloque le passage à la suite tant qu’il n’est pas vert. Une spec qui s’écarte de vos règles de design, un contrat qui casse la compatibilité, un test de contrat en échec : rien de tout ça n’avance dans le cycle de vie. La conformité arrête de dépendre d’une relecture humaine qu’on saute quand la deadline approche, et les écarts se voient à l’endroit où ils sont créés plutôt que six mois plus tard, en production, dans une trace d’agent.
La propagation. Une modification faite à une étape se répercute sur toutes les autres. Changer la spec régénère la collection, les mocks et les tests, et met à jour la documentation publiée. La source de vérité reste unique et toujours à jour, ce qui supprime la dérive silencieuse entre ce que l’API fait et ce que le contrat en dit. Pour un agent, cette dérive est exactement ce qui le fait tâtonner : il lit un contrat qui décrit une API qui n’existe plus.
Reprenons alors les cinq questions de l’agent, et l’étape qui répond à chacune.
Étape · Publication
Un catalogue unique, quelle que soit l'équipe ou la techno derrière, avec un propriétaire et un statut par API. L'agent cherche dans un seul endroit au lieu de fouiller trois portails et un wiki.
La règle d’idempotence citée dans le dernier onglet mérite un mot. Une personne relance un paiement échoué une fois, prudemment. Un agent le relance mille fois en une seconde. L’idempotence cesse d’être une bonne pratique et devient la frontière entre une relance et mille transactions dupliquées.
Sur ces cinq étapes, les bénéfices se rangent en trois familles, et elles ne servent pas que vos agents.
Standardisation
- Un seul catalogue pour tout le patrimoine
- Les mêmes règles sur toutes les API
- Une documentation au format constant
- Une API se réutilise au lieu d'être réécrite
Fiabilité
- Une source de vérité unique
- Des tests générés depuis le contrat
- Un contrôle automatique à chaque étape
- Les ruptures attrapées avant le consommateur
Productivité
- Les équipes travaillent en parallèle
- Plus d'exports qui circulent par mail
- Les consommateurs s'intègrent sur un mock
- Les erreurs de modélisation se voient à coût zéro
Une facture que personne ne sait découper
Vos API déterminent la fiabilité de l’agent. Elles ne vous disent pas ce que vous payez pour l’atteindre.
La situation typique, à ce stade : vous recevez la facture du fournisseur de modèle, et vous ne savez ni qui dépense, ni pour quel usage, ni par quel moyen. La dépense est indivisible. Elle arrive en un bloc.
Ce bloc recouvre au moins trois populations très différentes :
- Les agents de code, Claude Code, Codex, Cursor, utilisés par vos développeurs.
- Les agents en production, ceux qui parlent à vos clients ou à vos systèmes.
- Les agents locaux et personnels, montés par une équipe pour son propre usage, dont l’existence n’est parfois connue de personne d’autre.
Sans ce découpage, vous ne pouvez ni repérer les agents inefficaces, ceux qui bouclent douze fois là où un autre s’en sort en trois, ni réduire les coûts, faute de savoir où appuyer, ni répondre à la question que le CFO finira par poser sur l’impact réel de l’IA dans l’entreprise.
Comment on obtient cette visibilité
Il faut trois briques, et aucune ne remplace les autres.

Les traces et les logs donnent le fil d’exécution : combien de tours, quels outils appelés, où l’agent a tâtonné. C’est ce qui relie une facture à une cause. Un outil backend attache un coût en tokens à chaque trace, ce qui transforme « on a dépensé 700 dollars » en « cet agent dépense 1,50 dollar par requête et son voisin 0,005 ». Et une AI Gateway, point d’accès unique aux modèles, donne l’attribution par fournisseur et par modèle, y compris pour les usages que personne n’a déclarés.
Les agents de code se traitent autrement : on récupère les données au niveau du fournisseur, et on classifie les prompts par catégorie et par utilisateur. Sans cette classification, impossible de dire quelle part de la dépense Claude Code part en ingénierie logicielle plutôt qu’en rédaction, ou quelle part relève du professionnel plutôt que du personnel.
Une fois ces briques en place, vous avez une vue à 360 degrés : la dépense par agent, par utilisateur, par modèle, et la trace qui explique chaque ligne.
Ce que l’observabilité ne dit pas
L’observabilité dit ce qui s’est passé. Elle ne dit pas si c’était bon. C’est le rôle des évaluations, et les deux vont par paire : des évals sans observabilité n’ont pas de données à juger, de l’observabilité sans évals ne produit que des graphiques.
En pratique, on pose un point de contrôle à chaque étape de la boucle et on les évalue séparément.

Le travail réel est en amont : choisir les critères, métier, infrastructure, sécurité, et curer un jeu de données à évaluer à partir de vos traces, logs et transcripts. Ce jeu de données est l’actif qui rend l’itération possible. Sans lui, changer de modèle ou de prompt est une décision à l’aveugle, et vous n’avez aucun moyen de savoir si la version d’après est meilleure ou seulement différente.
C’est ce qui rend la customisation exploitable. Chaque brique de l’agent est remplaçable indépendamment, le harnais, le modèle, les outils, donc vous pouvez changer de modèle selon le besoin, mettre à jour le harnais en production, améliorer les outils connectés. Mesurez l’effet de chaque changement, sinon vous itérez au hasard.
Gouverner un programme non déterministe
Savoir ce que vous payez ne vous dit pas ce que vous risquez.
Un agent en production a deux frontières, et sur la plupart des projets rien ne filtre ni l’une ni l’autre.
Ce qui entre : un usage hors périmètre, une instruction cachée dans un document que l’agent lit, un droit que l’utilisateur n’a pas.
Ce qui sort : des données personnelles de clients envoyées vers un fournisseur tiers, une action irréversible sur vos systèmes, un engagement faux pris auprès d’un client, une réponse signée de votre marque.
Certaines factures se comptent en tokens, les autres se comptent en clients. Et vos tests couvrent ce que l’agent doit faire, quand les incidents viennent tous de ce qu’il peut faire.
Les incidents publics de ces trois dernières années ont tous la même structure : la règle censée tenir l’agent vivait dans son prompt, donc elle était négociable, et quelqu’un a fini par la négocier. Une règle qui reste dans le contexte n’est qu’une préférence.
Les garde-fous
La réponse est d’insérer des points de blocage aux différents moments de la boucle, indépendants de l’agent lui-même.
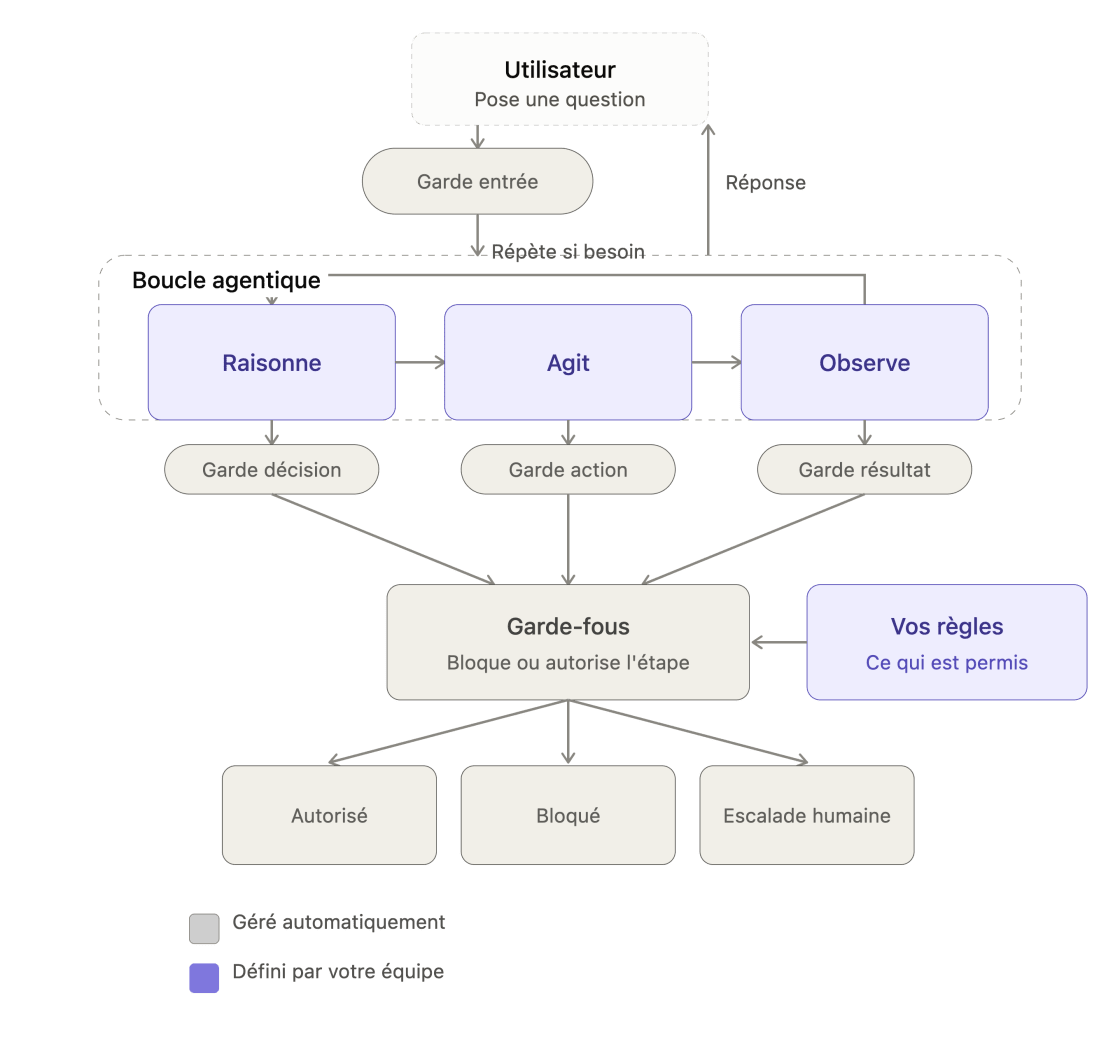
Les règles sont définies par vos équipes, et portent sur des thèmes distincts : sécurité du contenu, confidentialité des données, détection d’injection de prompt, permissions sur les actions, conformité. Le point important est structurel : ces contrôles sont indépendants de l’agent. Ils ne sont pas dans son prompt, donc il ne peut pas les contourner en étant convaincu du contraire.
La troisième issue compte autant que les deux autres. Un agent qui sait s’arrêter et demander vaut mieux qu’un agent qui a raison 95 % du temps sur des actions irréversibles.
Accès et identité
Voilà le contrôle qu’on oublie le plus souvent, et celui qui produit les fuites internes.
Un agent unique, partagé par plusieurs métiers, appelant plusieurs systèmes. Si l’agent appelle les API avec sa propre identité technique, il porte l’union des droits de tous ses utilisateurs. Un commercial obtient alors, via l’agent, des informations issues des dossiers RH, sans qu’aucun contrôle d’accès n’ait été franchi frauduleusement : les droits de l’agent étaient simplement plus larges que les siens.

L’agent doit porter l’identité de l’utilisateur jusqu’à l’API, pas la sienne. Trois questions à poser, dans cet ordre : qui a accès à quel agent, qui a accès à quoi via quel agent, et peut-on retrouver après coup les actions faites au nom de chaque utilisateur.
Deux couches pour répondre à tout ça
Attribuer la dépense, évaluer la qualité, filtrer ce qui entre et ce qui sort, tracer qui a fait quoi : ces besoins ne se règlent pas dans le code de l’agent, ils se règlent autour. Chez Postman, ils se répartissent sur deux couches.

Astro AI
Gouverne les agents
- Cataloguer les agents de l'organisation
- Mesurer leur qualité et leur adoption
- Contrôler leurs coûts et leurs accès
- Comprendre leur utilisation

Fabric
Gouverne les appels
- Cataloguer les LLM, les serveurs MCP et les API
- Contrôler leurs coûts et leurs accès
- Améliorer la fiabilité
- Comprendre leur utilisation
Si vous travaillez sur des agents branchés à vos systèmes, ou si vous pensez que je me trompe quelque part, écrivez-moi sur LinkedIn. Je serai ravi d’échanger.